서버에선 잘 됐는데 엣지에선 왜 정확도가 떨어지나
EDGE AI
같은 모델이라도 보드로 옮기는 길에서 결함 신호가 세 군데 깎이고, 그 손실은 평균 정확도보다 작은 결함의 재현율에서 먼저 드러납니다.
광택 없는 회색 사출 커버의 30 μm 흑점을 두고, 축소 보간과 8비트 칸과 런타임 세대가 각각 얼마를 깎는지 계산했습니다.
읽는 시간 약 12분
검사 대상은 광택 없는 회색 사출 커버이고, 찾을 것은 지름 30 μm 흑점입니다. 무광 면이라 배경은 고르게 밝지만, 흑점과 배경의 밝기 차이는 8비트 화면에서 여섯 단계 남짓으로 작다고 가정합니다. 이렇게 대비가 낮은 결함은 영상이 조금만 손을 타도 가장 먼저 지워집니다.
서버에서 검증을 마친 모델을 보드에 올리고 전체 정확도를 재면 99%대가 그대로 나와서 안심하기 쉽습니다. 그사이 흑점이 있는 커버 몇 개가 양품 상자로 가고, 출하 뒤 반품이 들어와서야 숫자가 무엇을 가렸는지 드러납니다. 재검 인력과 반품 처리 비용이 그 뒤를 따르죠.
범인을 찾는 일은 모델을 다시 학습하는 데서 시작하지 않습니다. 서버에서 보드로 가는 길 위의 세 자리, 영상을 줄이는 방식과 숫자를 8비트로 바꾸는 단계와 그 숫자를 실행하는 런타임을 차례로 재고, 판정은 작은 결함의 재현율로 내립니다.
평균 0.6%p 뒤에 숨은 재현율 20%p
평가 이미지 1,000장을 가정합니다. 정상 900장, 큰 결함 70장, 흑점 같은 작은 결함 30장입니다. 서버의 모델은 작은 결함 30장 가운데 29장을 잡고, 보드에 올린 같은 모델은 23장을 잡는다고 둡니다. 새로 놓친 6장을 전체 1,000장으로 나누면 0.6%p라서, 전체 정확도는 거의 움직이지 않은 것처럼 보입니다.
같은 6장을 작은 결함 30장으로 나누면 숫자가 달라집니다. 재현율1이 96.7%에서 76.7%로 20.0%p 떨어집니다. 작은 결함 다섯 개 가운데 하나를 보드가 새로 놓친다는 뜻이에요. 평균은 수가 많은 정상 이미지가 끌고 가니, 수가 적은 클래스의 손실은 평균 안에서 잘 보이지 않습니다.
0.6%p
보드에서 전체 정확도가 떨어진 폭 (평가 1,000장 가정)
20.0%p
같은 6장이 작은 결함 재현율에서 깎은 폭
그래서 보드로 옮긴 모델은 클래스마다 따로 잽니다. 제 기준으로 보드 검수표의 첫 줄은 작은 결함의 재현율입니다. 작은 결함의 재현율이 서버와 갈린다면, 다음 질문은 그 6장이 어디서 사라졌느냐입니다. 첫 번째 용의자는 영상이 모델에 들어가기 직전, 크기를 줄이는 자리에 서 있습니다.
줄이는 방식 하나로 남는 대비가 0에서 100%까지 흔들린다
검사 카메라 영상은 대개 모델 입력보다 커서 모델 앞에서 한 번 줄여 넣습니다. 이때 쓰는 보간2이 서버의 학습 파이프라인과 보드의 실행 파이프라인에서 다르면, 같은 흑점이 서로 다른 모습으로 모델에 들어갑니다. OpenCV의 resize는 따로 지정하지 않으면 쌍선형 보간(INTER_LINEAR)을 쓰고, 문서는 화소 면적 관계로 다시 표본을 뽑는 INTER_AREA를 영상을 줄일 때 무아레 없는 결과를 주는 방식으로 소개합니다. 가로세로 3 px인 흑점을 4분의 1로 줄이는 경우를 OpenCV로 계산했습니다. 흑점이 놓일 수 있는 16가지 자리마다 줄인 영상에 남는 대비의 최댓값을 보면, INTER_AREA는 25%에서 56%, INTER_LINEAR는 25%에서 100%, 가장 가까운 화소 하나를 고르는 INTER_NEAREST는 0%에서 100%입니다. INTER_NEAREST로 줄이면 16자리 가운데 7자리에서 흑점이 통째로 사라집니다.
학습은 INTER_AREA로 줄인 영상으로 했는데 보드의 전처리가 기본값인 INTER_LINEAR를 쓴다면, 모델은 학습 때 보지 못한 진한 흑점과 옅은 흑점을 섞어서 받습니다. 축소를 맡은 하드웨어나 다른 라이브러리가 가장 가까운 화소를 고르는 방식이라면, 흑점 일부는 모델에 닿기도 전에 사라집니다. 촘촘한 방충망 너머로 작은 점을 보면 망의 칸이 어디 걸리느냐에 따라 점이 보였다 말았다 하는 것과 같은 모양입니다.
저라면 서버와 보드의 전처리 코드를 나란히 놓고 보간 이름부터 맞춥니다. 이름이 같아도 축소를 카메라 안에서 하는지 보드의 코드에서 하는지가 다르면, 그 차이도 같은 표에 적어 둡니다. 축소 자리가 깨끗하다면 다음 의심은 숫자의 칸으로 넘어갑니다.
8비트 칸에서는 0.05의 차이가 묻힌다
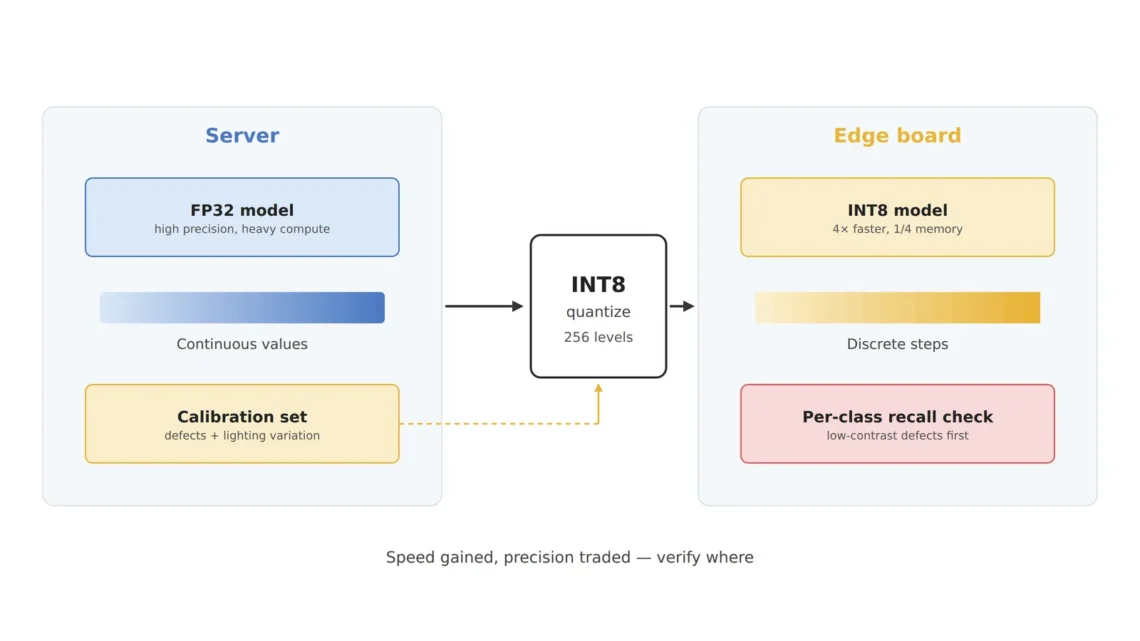
두 번째 용의자는 숫자의 칸입니다. INT8 양자화3는 32비트 실수로 계산하던 값을 256개의 정수 칸 가운데 하나로 바꿉니다. 값 하나가 4바이트에서 1바이트로 줄어 저장 공간은 4분의 1이 되고, 그 대가로 칸 사이에 낀 차이는 같은 칸으로 묶입니다.
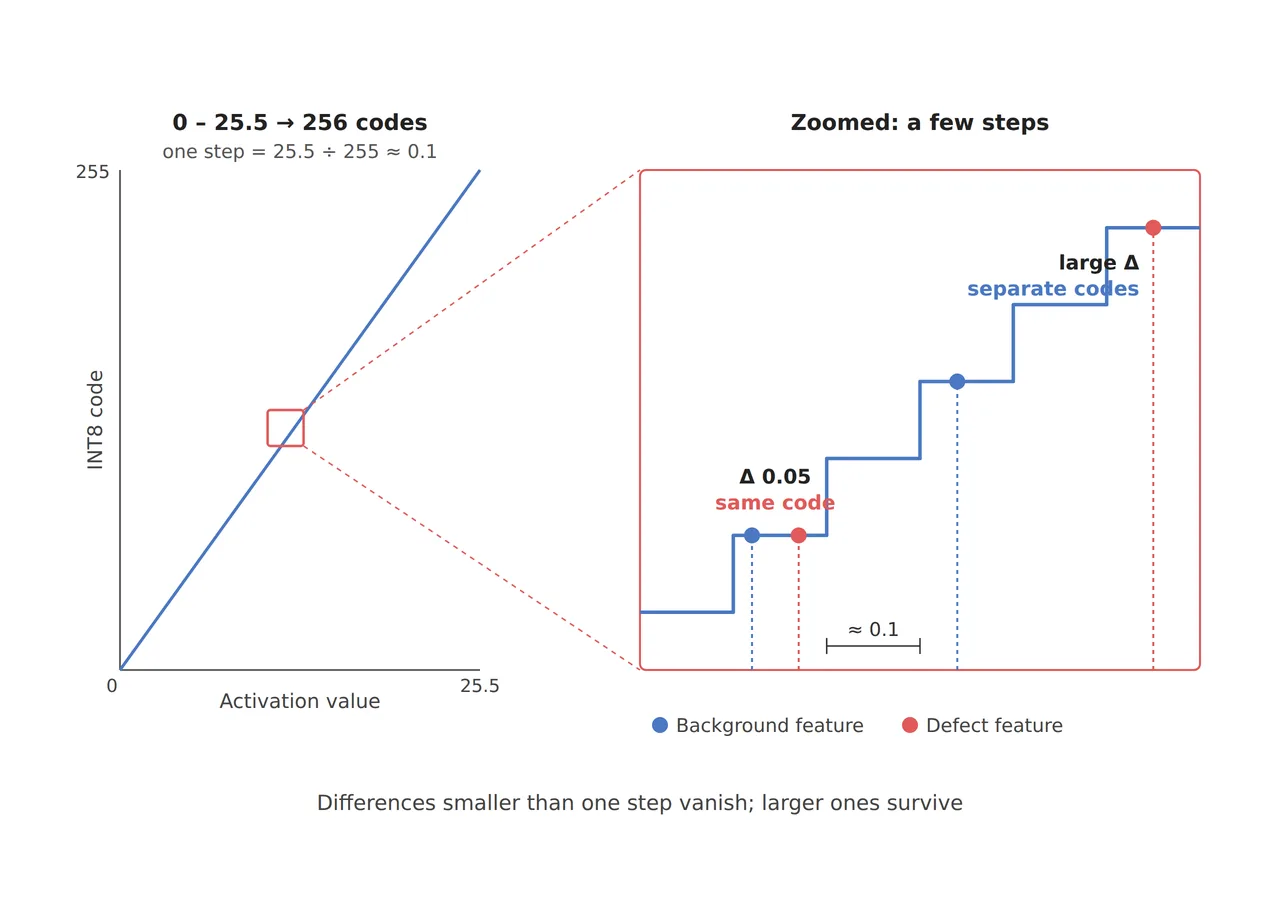
그림처럼 어느 층의 활성값4이 0에서 25.5 사이를 움직인다면 256칸의 한 칸은 25.5 ÷ 255 = 0.1입니다. 흑점과 배경의 특징값 차이가 0.05라면 두 값이 다른 칸으로 갈릴 확률은 차이를 칸 폭으로 나눈 0.05 ÷ 0.1 = 50%입니다. 나머지 절반은 같은 칸으로 묶여 모델 눈에 같은 값이 됩니다.
칸은 더 넓어질 수 있습니다. TensorRT5 문서는 대칭 양자화6 방식을 쓴다고 밝히는데, 0을 가운데 두는 대칭 방식에서는 음수 쪽 칸을 비워 둔 채 양수 쪽 127칸 남짓만 쓰게 되어 0~25.5 범위의 한 칸이 25.5 ÷ 127 = 0.2가 되고, 갈릴 확률은 25%로 내려갑니다. 캘리브레이션7 영상에 하얗게 날아간 반사점이 섞여 범위가 0~51로 늘어나면 한 칸은 0.4, 확률은 12.5%입니다. 범위 끝을 끌어올린 몇 장의 영상이 흑점 수백 장의 차이를 함께 지우는 셈이에요.
그래서 캘리브레이션 영상은 현장에 실제로 들어올 영상을 닮아야 합니다. 흑점이 든 커버와 조명·로트가 조금씩 다른 정상 커버를 함께 넣고, 반사점이 범위를 끌어올리는 장면은 현장에서 나오는 빈도에 맞춰 넣습니다. 저는 이 영상 목록을 정확도 표만큼 자세히 들여다봅니다. 민감한 층만 높은 정밀도로 남기는 혼합 정밀도8도 남은 길입니다. INT8에서 미세 결함이 사라지는 과정을 층별로 따라간 계산은 INT8 양자화 글에 따로 있습니다.
서버와 보드는 같은 TensorRT를 쓰지 않을 수 있다
세 번째 자리는 숫자를 실행하는 런타임입니다. TensorRT 10.x에서 11.x로 옮겨 가는 NVIDIA 문서는 Jetson 쪽 사정을 따로 적어 두었습니다. TensorRT 11.4.0은 JetPack을 지원하지 않고, Jetson 배포는 각 JetPack 버전이 지원하는 TensorRT 10.x에 머물러야 한다는 내용입니다.
같은 문서는 TensorRT 11.x에서 IInt8Calibrator와 그 하위 클래스가 모두 빠졌다고 적고, 대신 Model Optimizer로 양자화 지점(Q/DQ)9을 표시한 모델을 만들라고 안내합니다. 서버의 11.x는 Q/DQ 모델을 받고 보드의 10.x에는 이전 방식의 캘리브레이터가 남아 있으니, 같은 모델이라도 8비트 칸을 정하는 길이 서버와 보드에서 달라질 수 있습니다. 저라면 서버와 보드 각각에서 실제로 쓴 TensorRT 버전과 양자화 경로를 정확도 표 옆에 적어 둡니다.
같은 영상을 양쪽에 넣어 범인을 가른다
세 용의자는 실험 하나로 가를 수 있습니다. 카메라로 받은 원본 영상을 파일로 저장해 서버와 보드에 똑같이 넣고, 전처리를 마친 입력 텐서10와 모델의 출력을 양쪽에서 함께 저장합니다. 입력 텐서부터 다르다면 축소와 색 변환 같은 전처리가 범인이고, 입력은 같은데 출력이 다르다면 숫자의 칸이나 런타임 쪽입니다.
출력이 갈렸다면 보드에서 정밀도만 바꿔 한 번 더 돌립니다. 같은 모델을 FP16 엔진으로 만들었을 때 작은 결함의 재현율이 서버와 맞으면 8비트 칸이, 그래도 갈리면 런타임 버전 차이가 남습니다. 이 순서로 가면 사라진 6장이 어느 자리에서 빠졌는지 셀 수 있고, 저는 그 숫자 없이 모델을 다시 학습하지 않습니다. 흑점 크기부터 양자화 설정까지 세 줄을 한 표에 놓으면 아래와 같습니다.
| 항목 | 기준값 | 조건·근거 | 풀어 쓰면 |
|---|---|---|---|
| ① 최소 불량 사이즈 | 지름 30 μm 흑점 = 3 px | 분해능 10 μm/px 가정, 배경과의 밝기 차 8비트 6단계 가정 | 흑점이 화소 세 칸에 겨우 걸린다 |
| ② 광학 셋업 · WD | 무광 커버, 확산 동축 또는 돔 조명, WD{fn(11)}와 초점은 학습 때와 같게 | 조명·WD·초점이 바뀌면 흑점 대비가 학습 분포에서 벗어난다 | 학습할 때와 같은 높이, 같은 빛으로 찍는다 |
| ③ 알고리즘 파라미터 | 축소 보간 일치, 캘리브레이션 범위 관리, 작은 결함 재현율 하락 허용 2%p | INTER_AREA 25~56%, INTER_LINEAR 25~100%. 칸 폭 0.1·0.2·0.4. 허용치 2%p는 가정 | 줄이는 방법과 칸 폭을 서버와 보드에서 같게 맞춘다 |
세 줄 가운데 서버와 보드를 가르는 줄은 ③입니다. ①의 3 px 흑점은 축소 방식에 따라 25%의 대비만 남을 수 있고, 그 옅어진 흑점이 다시 8비트 칸에 묶이니 손실이 두 번 겹칩니다. ②의 조건을 학습 때와 같게 묶어 두는 일은 ③을 따지기 전에 끝내야 하는 바닥 작업입니다. 광택이 섞인 표면이라면 반사점이 범위를 늘리는 정도가 커져서, 이 계산이 현장 숫자와 얼마나 맞을지는 샘플 테스트 전 확언 불가입니다.
서버의 숫자와 보드의 숫자가 갈리는 자리를 찾아 메우는 일은 엣지 AI 엔지니어의 일 가운데 큰 몫이고, 영상 처리와 숫자 표현을 함께 읽는 눈이 그 일의 밑천입니다. 라인 투자를 승인하는 쪽에서 보면 서버 검증 정확도만으로 도입을 정하기보다, 보드 위에서 잰 클래스별 재현율을 검수 조건에 넣는 편이 안전합니다. 이 글은 기술 설명이며 투자 권유가 아닙니다. 자세한 내용은 면책조항을 참고하세요.
현장 노트
이 커버를 보드로 옮긴다면 저는 흑점이 든 커버 30장을 따로 모아 두고, 서버와 보드에서 같은 30장의 재현율만 따로 셉니다. 30장 가운데 하나라도 보드에서만 놓친다면, 그 영상의 입력 텐서를 양쪽에서 저장해 축소 단계의 값부터 맞대어 봅니다. 반사점이 섞인 영상이 캘리브레이션 세트에 몇 장 들어 있는지도 같은 날 셉니다.
현장 체크포인트
흑점 30장의 재현율이 양쪽에서 나오면, 아래 질문으로 서버와 보드 사이의 길을 하나씩 점검합니다.
- 전체 정확도 대신 작은 결함 클래스의 재현율을 서버와 보드에서 따로 비교했는가? (평균 0.6%p 뒤에 재현율 20%p가 숨을 수 있으니)
- 서버 학습과 보드 실행의 축소 보간이 같은가? (INTER_AREA와 INTER_LINEAR는 같은 흑점에 다른 대비를 남긴다)
- 캘리브레이션 영상에 흑점이 든 커버와 조명·로트 변주가 들어 있는가? (정상 영상만으로 범위를 잡지 않는지)
- 반사점이 범위를 늘리는 영상이 캘리브레이션 세트에 현장 빈도보다 많이 들어 있지 않은가? (범위가 두 배면 칸 폭도 두 배)
- 서버와 보드의 TensorRT 버전과 양자화 경로를 기록했는가? (Jetson은 JetPack이 지원하는 10.x에 머문다)
- 학습 영상과 현장 영상이 같은 WD와 초점, 같은 조명에서 찍혔는가? (렌즈 높이가 바뀌면 흑점의 화소 수부터 달라진다)
자주 묻는 질문
INT8 대신 FP16으로 배포하면 문제가 사라지나요?
FP16은 칸이 훨씬 촘촘해서 0.05 같은 차이가 묻힐 일이 크게 줄어듭니다. 대신 값 하나가 2바이트라 INT8보다 메모리와 대역폭을 두 배 쓰고, 그만큼 속도 이점도 줄어듭니다. 민감한 층만 FP16으로 남기는 혼합 정밀도가 절충이 되고, TensorRT 11 문서는 그 변환에 Model Optimizer의 AutoCast를 쓰라고 안내합니다.
축소 없이 원본 크기로 넣으면 이 문제가 다 사라지나요?
보간 차이는 사라지지만 연산량이 입력 화소 수에 비례해 늘어서 보드의 시간 예산이 먼저 바닥납니다. 그래서 흑점이 생기는 구역만 원본 해상도로 잘라 넣는 방식을 함께 봅니다. 자르는 위치와 겹침은 타일링 추론 글에서 계산해 두었습니다.
용어 풀이
- [1] 재현율 recall
실제 결함 가운데 모델이 결함이라고 잡아낸 비율입니다. 30장 중 23장을 잡으면 76.7%입니다. ↩ - [2] 보간 interpolation
영상을 줄이거나 키울 때 새 화소의 값을 주변 화소에서 정하는 계산입니다. 어떤 방식을 쓰느냐에 따라 작은 점이 진해지기도 하고 흐려지기도 합니다. ↩ - [3] INT8 양자화 INT8 quantization
32비트 실수를 8비트 정수로 바꿔 계산을 가볍게 하는 과정입니다. 연속된 경사로를 256개 계단으로 바꾸는 일에 가깝습니다. ↩ - [4] 활성값 activation
신경망의 각 층을 지나며 계산되는 중간 값입니다. 결함이 있으면 이 값들이 배경과 조금씩 다르게 나옵니다. ↩ - [5] TensorRT TensorRT
NVIDIA GPU와 Jetson에서 학습된 모델을 빠르게 실행하도록 최적화하는 런타임입니다. ↩ - [6] 대칭 양자화 symmetric quantization
0을 가운데 두고 양수와 음수에 같은 칸 폭을 쓰는 양자화입니다. 양수만 나오는 층에서는 절반의 칸이 비어 칸 폭이 넓어집니다. ↩ - [7] 캘리브레이션 calibration
대표 영상을 흘려 각 층의 값 범위를 재고 8비트 칸의 폭을 정하는 단계입니다. ↩ - [8] 혼합 정밀도 mixed precision
층마다 다른 숫자 형식을 섞어 쓰는 방식입니다. 민감한 층은 FP16으로, 나머지는 INT8로 둡니다. ↩ - [9] Q/DQ quantize / dequantize
모델 안에 어디서 8비트로 바꾸고 어디서 되돌리는지를 표시한 노드입니다. ↩ - [10] 입력 텐서 input tensor
전처리를 마치고 모델에 들어가기 직전의 숫자 배열입니다. 서버와 보드에서 이 배열이 같아야 비교가 공정합니다. ↩ - [11] WD working distance, 작동 거리
렌즈 앞에서 검사할 면까지의 거리입니다. 이 거리가 바뀌면 같은 흑점도 다른 화소 수로 찍힙니다. ↩
참고 자료
- NVIDIA, TensorRT 11.4.0 Documentation, Working with Quantized Types (대칭 양자화 방식), 2026년 10월 24일 열람
- NVIDIA, Migrating TensorRT from 10.x to 11.x on Jetson/JetPack (IInt8Calibrator 계열 제거, Model Optimizer Q/DQ, AutoCast, TensorRT 11.4.0의 JetPack 미지원, Jetson은 TensorRT 10.x 유지), 2026년 10월 24일 열람
- OpenCV 4.x Documentation, Geometric Image Transformations (resize 기본 보간 INTER_LINEAR, INTER_AREA 설명), 2026년 10월 24일 열람
- 계산식: 재현율 = 잡은 결함 ÷ 전체 결함, 정확도 하락 = 새로 놓친 장수 ÷ 전체 장수, 칸 폭 = 범위 ÷ 255(비대칭) 또는 최대 절댓값 ÷ 127(대칭), 다른 칸으로 갈릴 확률 ≈ 차이 ÷ 칸 폭. 축소 뒤 대비는 OpenCV resize로 3 × 3 px 점을 16가지 자리에서 4분의 1로 줄여 계산
함께 읽으면 좋은 글 — Jetson Orin Nano 초기 셋업에서 막히는 네 가지 · 엣지 검사의 입력 드리프트는 정확도보다 먼저 보인다 · 엣지 AI 비전이 현장에서 안 돌아가는 이유

Noctvision
2005년부터 생산설비의 기계설계와 프로젝트 관리를 맡아 온 엔지니어입니다. 설비에 들어가는 카메라·렌즈·조명을 수식과 공개 자료로 계산하고, 가정과 출처를 함께 밝혀 기록합니다.


함께 읽으면 좋은 글
엣지 AI 추론 지연은 NPU보다 카메라 인터페이스가 먼저 정한다
AOI의 불량 판정에 비전 언어 모델로 근거를 붙이려면