검출과 분류를 한 모델로 — KLA 통합 CNN 특허의 트레이드오프
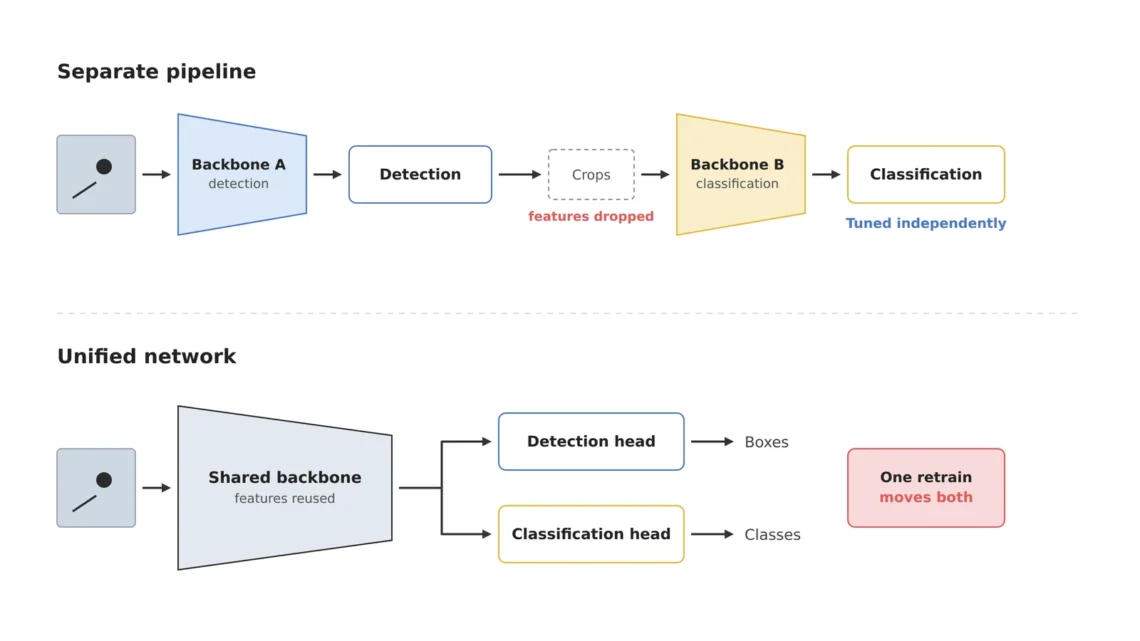
표면 결함을 검출하는 모델과 그 결함을 등급별로 분류하는 모델을 따로 두면, 두 모델 사이 정보 손실이 생긴다. 검출은 잘 됐는데 분류에서 오판이 나는 경우가 대표적이다. KLA의 등록특허 US10607119B2(“Unified neural network for defect detection and classification”)는 이 문제를 단일 통합 CNN으로 풀겠다는 접근이다.
핵심은 검출과 분류를 하나의 신경망 안에서 동시에 수행한다는 점이다. 검출 단계에서 뽑아낸 특징(feature)을 분류 단계가 그대로 재사용하니, 별도 파이프라인 두 개를 운영할 때보다 처리 속도와 일관성 면에서 유리할 수 있다. 다만 통합 모델은 검출과 분류 각각을 독립적으로 튜닝하기 어렵다는 반대급부가 있다 — 한쪽 성능을 올리려는 재학습이 다른 쪽 성능을 흔들 수 있는 조건에서는, 오히려 분리형 파이프라인이 유리하다.
| 항목 | 내용 |
|---|---|
| 특허번호 | US10607119B2 |
| 출원인 | KLA Corp |
| 핵심 기술 | 단일 통합 CNN 기반 결함 검출·분류 동시 수행 |
통합이냐 분리냐를 가르는 기준
통합형과 분리형의 선택은 모델 구조의 취향이 아니라 어느 쪽 오류가 더 비싼지와 결함 목록이 얼마나 자주 바뀌는지로 정해진다. 통합 모델은 검출과 분류가 같은 특징을 공유하므로, 한 번의 재학습이 두 성능을 동시에 움직이기 때문이다. 예를 들어 결함 유형이 분기마다 새로 추가되는 라인이라면, 분류 클래스를 늘리려는 재학습이 검출 재현율까지 흔들 위험을 매번 떠안게 된다. 반대로 결함 목록이 안정적이고 처리 속도가 중요한 라인이라면 특징 재사용의 이점이 커진다. 그래서 아키텍처를 정하기 전에 미검출·오분류 각각의 비용과 결함 목록의 변경 빈도를 먼저 적어 보는 것이 순서다.
어느 구조를 고르든 입력 이미지의 품질이 상한을 정한다는 점은 같다. 결함이 이미지에 충분한 크기와 대비로 담기지 않으면 통합이든 분리든 모델이 복원할 정보가 없다.
검출·분류 모델 도입 골격
| 항목 | 내용 |
|---|---|
| ① 최소 불량 사이즈 | 사양에서 정의(예시 가정: 20 μm) — 3 px 이상으로 담으려면 분해능 약 6.7 μm/px 이하 |
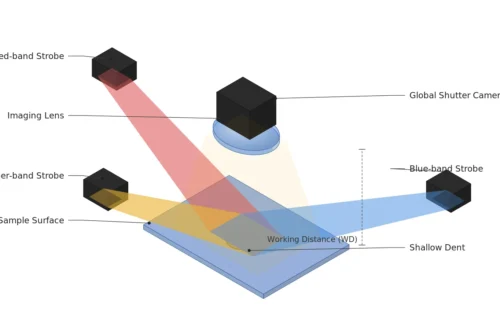
| ② 광학 셋업 | 검출용 대비와 분류용 형태 정보를 한 이미지에 담아야 하므로 명시야·암시야 병행 촬영 검토, 두 조명을 넣은 상태에서 렌즈 WD 확보 |
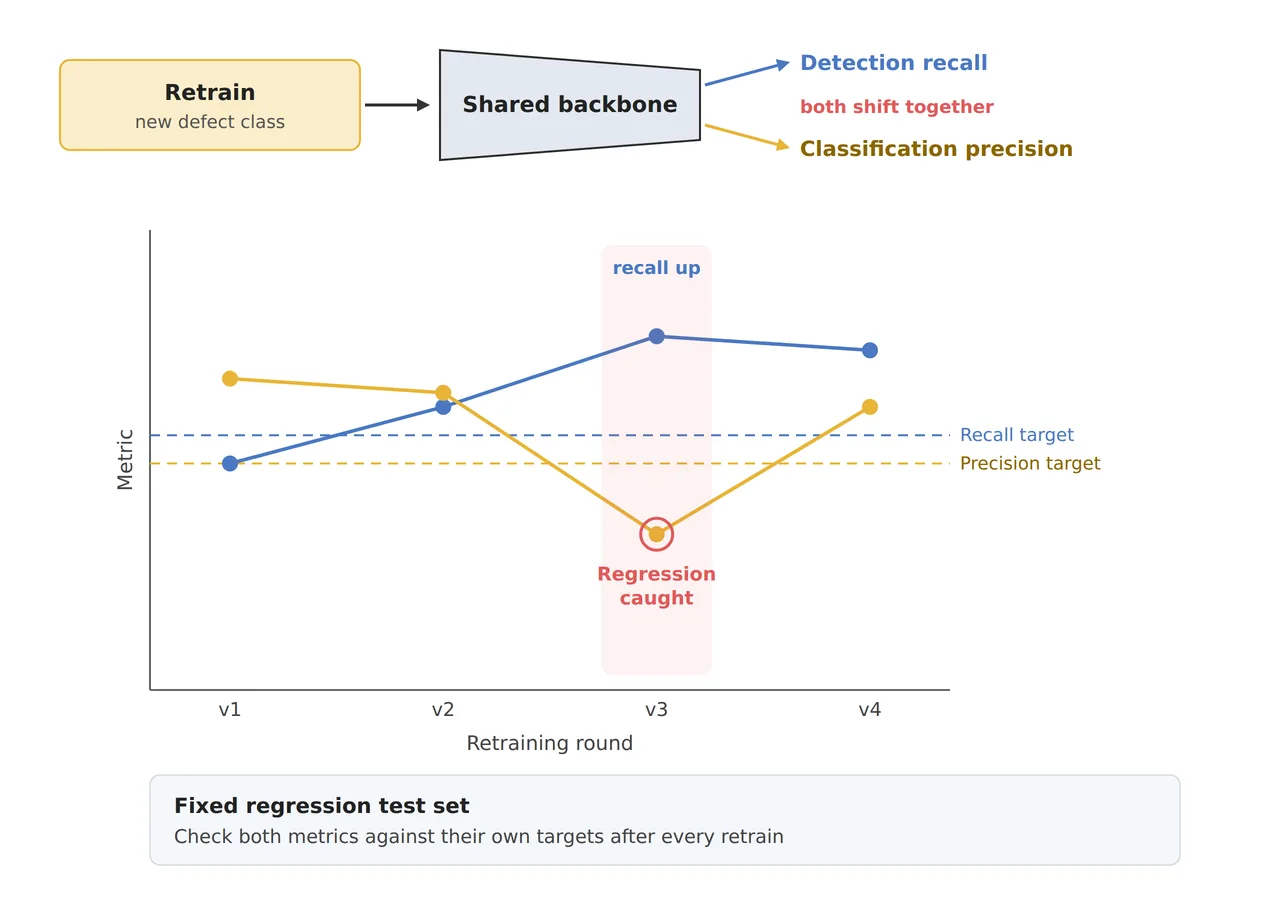
| ③ 알고리즘 파라미터 | 검출 재현율과 분류 정밀도의 목표치를 각각 정의, 공유 백본 재학습 때마다 두 지표를 함께 보는 회귀 테스트 세트 고정 |
표에서 ③의 두 지표를 따로 두는 것이 핵심이다. 통합 모델을 쓰더라도 성능 관리는 분리해서 해야 트레이드오프가 보인다.
자주 묻는 질문
Q. 통합 모델로 가면 추론 속도는 얼마나 빨라지나?
검출 단계의 특징을 다시 계산하지 않아도 되므로 유리할 수 있지만, 실제 이득은 모델 크기와 결함 후보 수에 따라 달라진다. 같은 하드웨어에서 두 구성을 모두 재 보기 전에는 확언 불가하다.
Q. 분리형을 쓰면 정보 손실은 어떻게 줄이나?
분류 모델에 결함 후보 이미지만 넘기지 말고 주변 영역과 검출 점수를 함께 넘기면, 두 단계 사이에서 잃는 맥락을 일부 보완할 수 있다.
현장 체크포인트
- 검출·분류 정확도를 각각 따로 측정해, 통합 모델이 실제로 둘 다 개선하는지 확인했는가
- 결함 유형이 늘어날 때 재학습 범위가 검출 성능까지 흔드는지 검증했는가
- 명시야·암시야 조명을 넣은 상태에서 렌즈 WD(작동거리)가 확보되는가
- 통합형과 분리형 중 어느 쪽이 유리한지는 결함 목록과 비용 구조에 따라 뒤집힌다 — 같은 샘플 세트로 비교하기 전에는 확언 불가
출처: Google Patents
현장 노트
검출과 분류를 한 모델로 합치면 파이프라인은 깔끔해 보이지만, 검출 재현율을 올리려고 튜닝하면 분류 정밀도가 같이 흔들리는 걸 겪었습니다. 통합이냐 분리냐는 어느 쪽 오류가 더 비싼지에 따라 달라서, 아키텍처를 정하기 전에 그 계산부터 해봅니다.


함께 읽으면 좋은 글
멈춰야만 보이던 표면 — 컬러 다중화 스트로빙이 포토메트릭 스테레오의 정지 조건을 깨는 방법
Few-Shot 이상탐지(Few-Shot Anomaly Detection): 결함 샘플 5장으로 검사 라인을 세울 수 있는가