검출과 분류를 한 신경망에 묶은 KLA 특허의 대가
ALGORITHM
검출과 분류를 한 신경망에 묶으면 후보가 많은 화면은 네 배 넘게 빨라지지만, 재학습 한 번이 두 성능을 함께 흔듭니다.
KLA의 통합 신경망 특허 US10607119B2를 읽고, PCB 한 장을 49프레임으로 찍는 검사에 옮겨 속도와 회귀 테스트의 크기를 계산했습니다.
읽는 시간 약 10분
녹색 솔더 마스크 위에 동박 패드가 드러난 PCB는 한 화면 안에 성질이 다른 두 면을 담습니다. 솔더 마스크는 빛을 비교적 고르게 흩고, 동박 패드는 거울처럼 한 방향으로 튕겨 내서 같은 조명 아래에서도 밝기 차이가 큽니다. 이 화면에서 폭 20 μm 이상의 흠을 찾는 검출1과, 그 흠이 긁힘인지 이물인지 동박이 덜 깎인 자리인지 이름을 붙이는 분류2를 함께 맡깁니다.
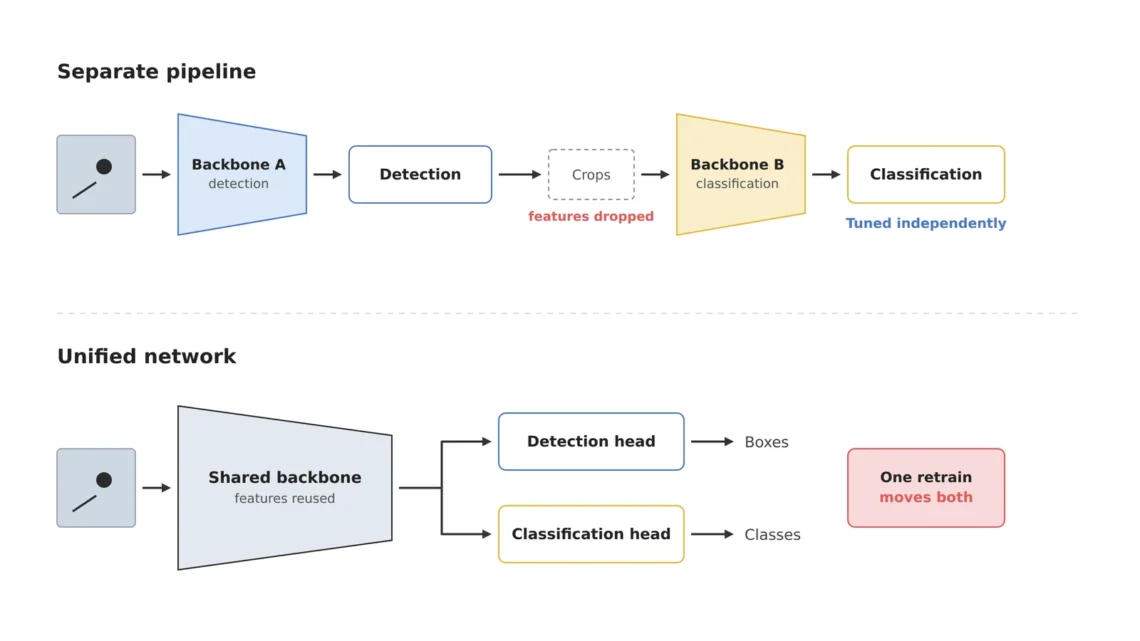
두 일을 모델 두 개로 나누면 검출 모델이 잘라 준 작은 조각만 분류 모델에 넘어가서 주변 맥락이 사라지고, 검출은 맞았는데 이름을 잘못 붙이는 오분류가 생깁니다. 이름이 틀리면 수리 공정으로 가야 할 기판이 폐기되거나, 폐기할 기판이 수리대에서 시간을 잡아먹습니다. 두 비용 모두 검사기 화면에는 맞게 찾았다고만 남습니다.
KLA의 미국 등록특허 US10607119B2(Unified neural network for defect detection and classification)는 이 둘을 신경망3 하나에 묶는 구조를 다룹니다. 저는 이 구조가 얼마나 빠른지, 그리고 그 대가로 무엇을 내주는지를 숫자로 따져 봅니다.
특허가 묶은 것은 특징을 뽑는 앞단이다
Google Patents에 공개된 서지 정보로는 우선일과 출원일이 2017년 9월 6일, 등록일이 2020년 3월 31일이고, 원출원인은 KLA-Tencor, 현재 권리자는 KLA Corp입니다. 요약에 따르면 신경망의 앞부분인 백본4이 시편 이미지에서 특징을 뽑고, 뒷부분이 그 특징을 받아 결함을 검출하고 분류까지 합니다. 명세서에는 후보 상자를 제안하는 망으로 결함 자리를 찾고, 상자 안의 특징만 모으는 ROI 풀링5으로 종류를 가리는 방식이 적혀 있습니다. 사용자가 붙인 결함 종류 이름으로 학습하고, 미리 학습된 가중치에서 출발해 다듬거나 처음부터 학습하는 경우도 함께 설명됩니다.
핵심은 특징을 한 번만 뽑는다는 점입니다. 분리형에서는 검출 모델이 화면 전체에서 특징을 뽑고, 분류 모델이 잘라 받은 조각에서 특징을 다시 뽑습니다. 통합형은 이미 뽑아 둔 특징 지도에서 상자 자리만 떼어 쓰니 같은 계산을 두 번 하지 않습니다. 공항에 빗대면 분리형은 출입국 심사대와 세관이 같은 여행자를 처음부터 따로 훑는 구조이고, 통합형은 한 번 찍은 기록을 두 창구가 나눠 보는 구조예요.
PCB 한 장은 49프레임으로 찍힌다
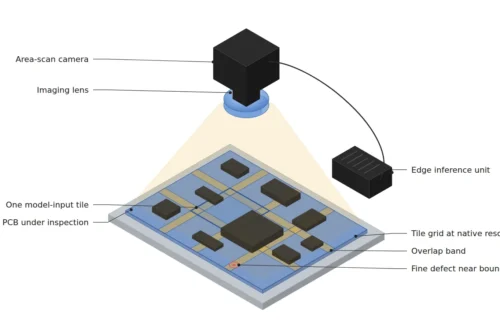
속도를 따지려면 먼저 한 장을 몇 번 찍는지 알아야 합니다. 20 μm 흠을 세 화소 이상으로 담는 것이 제 기준이라 화소 하나는 기판 위에서 6.67 μm 이하여야 하고, 2,448 × 2,048 px, 화소 3.45 μm 센서라면 한 프레임의 시야가 16.3 × 13.7 mm입니다. 35 mm 렌즈로 이 배율 0.518배를 만들면 렌즈에서 기판까지의 WD6가 약 103 mm입니다(얇은 렌즈 근사).
기판을 100 × 80 mm로 두고 이웃 프레임을 10 %씩 겹치면 가로 7장, 세로 7장, 모두 49프레임입니다. 흠의 대비를 보는 명시야7 장과 흠의 모양을 띄우는 암시야8 장을 같은 자리에서 연달아 찍어 두 채널로 겹쳐 넣는다고 가정하면, 신경망이 특징을 뽑는 횟수는 기판 한 장에 49번입니다. 이 49라는 숫자가 구조에 따른 시간 차이를 기판 한 장 단위로 키웁니다.
후보가 많을수록 통합의 이득이 커진다
지연 시간은 가정값으로 비교합니다. 백본이 한 프레임의 특징을 뽑는 데 40 ms, 분리형의 분류 모델이 후보 하나를 잘라 다시 보는 데 4 ms, 통합형의 분류 머리가 공유 특징에서 후보 하나를 가리는 데 0.3 ms가 든다고 둡니다. 후보가 프레임당 5개라면 분리형은 60 ms, 통합형은 41.5 ms라서 31 % 빨라지고, 기판 한 장으로는 2.94초가 2.03초가 됩니다. 후보가 50개로 늘면 240 ms 대 55 ms로 네 배 넘게 벌어지고, 한 장에 11.8초와 2.7초입니다.
숫자를 보면 통합의 이득이 후보 수에 비례한다는 점이 드러납니다. 후보가 시간을 정합니다. 깨끗한 기판처럼 후보가 몇 개 없는 화면에서는 백본의 40 ms가 시간을 거의 다 차지해서, 구조를 바꿔도 줄어드는 몫이 작습니다. 이물이 많은 공정이나 감도를 높여 후보가 쏟아지는 검사일수록 통합 구조가 값을 합니다. 실제 지연은 모델 크기와 하드웨어에 따라 크게 달라서, 저는 같은 장비에서 두 구성을 모두 재기 전에는 이 비율을 믿지 않습니다.
4.4배
후보 50개일 때 통합형이 빠른 정도 (240 ms 대 55 ms)
31%
후보 5개일 때 줄어드는 시간
49프레임
100 × 80 mm 기판 한 장을 덮는 촬영 수
재학습 한 번이 두 성능을 함께 움직인다
속도의 대가는 재학습에서 나옵니다. 검출과 분류가 같은 백본을 쓰니, 새 결함 유형을 넣으려고 다시 학습하면 백본이 바뀌고 검출 쪽 성능까지 움직입니다. 새 유형이 분기마다 하나씩 생기는 공정이라면 분류를 고치려던 재학습이 매번 검출 재현율9을 흔들 위험을 함께 떠안습니다. 이름을 맞히는 정밀도10가 오른 재학습에서 놓치는 흠이 늘었다면 그 재학습은 손해입니다. 빨라진 값을 거기서 돌려줍니다.
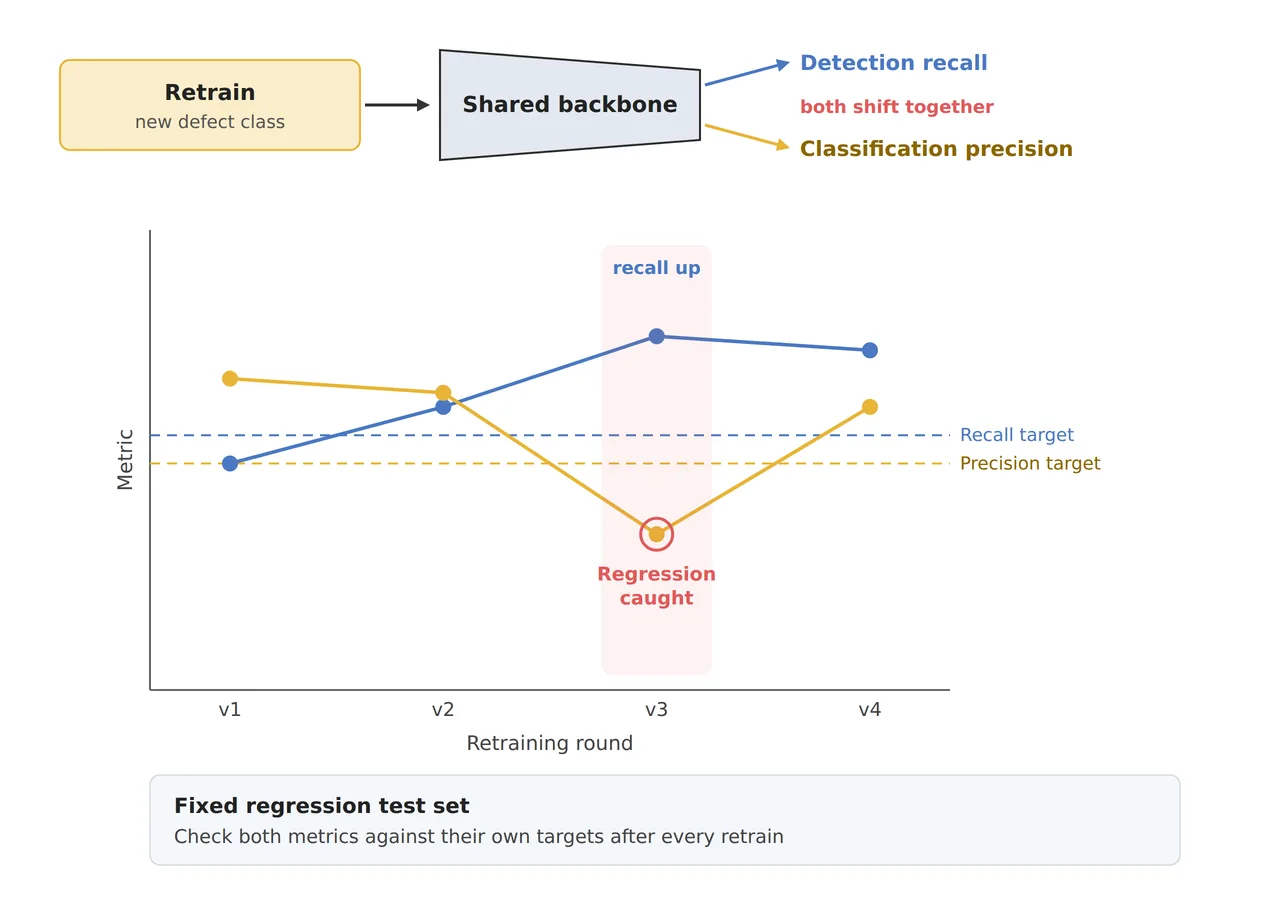
그림은 공유 백본을 다시 학습할 때마다 두 지표를 따로 그린 개념도입니다. 재현율이 오른 재학습에서 분류 정밀도가 목표선 아래로 내려간 지점을, 고정해 둔 회귀 테스트 세트11가 잡아냅니다. 그 세트가 얼마나 커야 하는지도 계산할 수 있습니다.
재현율 95 %를 결함 n장으로 잴 때 95 % 신뢰 구간의 반폭은 1.96 × √(0.95 × 0.05 ÷ n)이라, 50장이면 ±6.0 %p, 300장이면 ±2.5 %p입니다. 5 %p 하락을 확실히 가르려면 두 재학습의 구간이 겹치지 않아야 하니, 중요한 유형마다 결함 300장 안팎을 회귀 세트에 고정해 두는 것을 제 기준으로 삼습니다. 50장짜리 세트로는 95 %와 90 %가 같은 숫자로 보입니다.
새 유형을 넣을 때 백본을 얼려 두고 분류 머리만 다시 학습하면 검출 쪽은 흔들리지 않습니다. 대신 새 유형이 기존 특징으로 잘 갈리지 않으면 분류 정밀도가 오르지 않아서, 어느 쪽을 택할지는 회귀 세트의 두 숫자를 나란히 놓고 정합니다. 백본까지 다시 학습했다면 검출 재현율이 2.5 %p 넘게 내려가지 않았는지가 제 첫 확인 항목입니다.
결함 목록이 얼마나 자주 바뀌는지가 구조를 고른다
검출과 분류를 한 표에 놓으면 무엇을 따로 관리해야 하는지가 보입니다. 같은 카메라와 같은 WD를 쓰더라도 검출은 놓치지 않는 쪽으로, 분류는 이름을 틀리지 않는 쪽으로 목표가 갈리고, 속도는 후보 수가 정합니다.
| 구분 | ① 최소 불량 크기 | ② 광학 셋업 · WD | ③ 알고리즘 파라미터 · 풀어 쓰면 |
|---|---|---|---|
| 검출 (자리 찾기) | 폭 20 μm = 3칸 (6.67 μm/px 이하) | 명시야 장, 35 mm 렌즈, WD 약 103 mm, 시야 16.3 × 13.7 mm, 기판 한 장 49프레임 | 재현율 목표 95 %. 유형마다 결함 300장 회귀 세트로 재학습 때마다 ±2.5 %p 안에서 확인 |
| 분류 (이름 붙이기) | 같은 후보 상자 | 암시야 장을 더해 두 채널 입력, 같은 렌즈·WD | 유형별 정밀도 목표를 따로 적는다. 새 유형은 백본을 얼린 재학습과 전체 재학습을 회귀 세트로 비교 |
| 속도 | 후보 수가 변수 | 두 조명을 번갈아 찍는 촬영 시간은 별도 계산 | 후보 5개면 41.5 ms 대 60 ms, 50개면 55 ms 대 240 ms (가정 지연값). 이득은 후보 수에 비례 |
표에서 검출과 분류의 목표를 따로 적는 이유는, 모델이 하나여도 두 성능은 따로 움직이기 때문입니다.
분리형이 나은 자리도 분명합니다. 결함 유형이 분기마다 새로 생기거나, 검출 성능을 고객 승인 항목으로 따로 묶어 두어야 하거나, 후보가 프레임당 몇 개 안 되는 라인이라면 두 모델을 나누는 편이 관리가 쉽습니다. 분리형의 정보 손실은 분류 모델에 결함 조각만 넘기지 말고 주변 영역과 검출 점수를 함께 넘겨 일부 메울 수 있습니다. 반대로 결함 목록이 안정되고 후보가 많고 택트가 빠듯한 라인에서는 통합형의 속도가 값을 합니다. 동박 패드의 반사가 섞인 화면에서 두 구조의 성능 차이가 실제로 얼마인지는 샘플 테스트 전 확언 불가입니다.
모델 구조를 고르는 일은 비전 알고리즘 엔지니어의 몫이지만, 그 판단에 쓰는 숫자인 후보 수, 유형 추가 주기, 회귀 세트 크기는 품질과 생산 담당자도 함께 셀 수 있습니다. 설비에 투자하는 쪽에서는 통합 AI라는 이름보다 재학습 때마다 두 성능을 따로 보고하는지가 검사기의 운영 비용을 더 잘 알려 줍니다. 이 글은 기술 설명이며 투자 권유가 아닙니다. 자세한 내용은 면책조항을 참고하세요.
현장 노트
이 구조를 검토한다면 저는 새 유형 하나를 추가하는 재학습을 일부러 한 번 돌려 보고, 결함 300장짜리 회귀 세트에서 검출 재현율이 몇 %p 움직이는지부터 봅니다. 2.5 %p 안쪽이면 통합 구조를 그대로 두고, 넘으면 백본을 얼린 재학습과 비교합니다. 후보 수는 기판 한 장의 49프레임에서 하나하나 세어, 평균이 5개 안팎이면 속도 이득은 크게 기대하지 않습니다.
현장 체크포인트
재학습 한 번과 후보 수 집계로 두 가정을 확인했다면, 아래 질문으로 구조를 정합니다.
- 명시야·암시야 두 조명을 넣은 상태에서 WD 약 103 mm(35 mm 렌즈, 시야 16.3 mm)가 확보되는가? (두 조명이 렌즈와 기판 사이에 들어갈 자리가 있는지)
- 검출 재현율과 분류 정밀도의 목표를 따로 적었는가?
- 중요한 유형마다 회귀 세트에 결함이 300장 안팎 있는가? (50장이면 ±6 %p라 5 %p 하락이 보이지 않는지)
- 프레임당 결함 후보 수를 세어 통합 구조의 속도 이득을 계산했는가?
- 새 결함 유형이 얼마나 자주 추가되는지 확인했는가? (분기마다라면 분리 구조도 함께 검토하는지)
- 동박 패드처럼 반짝이는 자리와 솔더 마스크가 섞인 화면에서 두 성능을 샘플로 확인했는가?
자주 묻는 질문
통합 모델이면 검출 성능도 저절로 좋아지나요?
꼭 그렇지는 않습니다. 공유 백본은 검출과 분류 두 목표를 함께 맞추도록 학습되어서, 학습 데이터에서 분류 쪽 비중이 크면 특징이 분류에 유리한 쪽으로 기울 수 있습니다. 같은 학습 데이터로 분리형과 통합형을 각각 만들어 회귀 세트에서 재현율을 따로 재 보기 전에는 어느 쪽이 낫다고 판단하지 않습니다.
특허가 있는 구조를 그대로 써도 되나요?
특허 침해 여부는 청구항과 실제 구현을 하나씩 대조해야 하는 법률 판단이라 별도 검토가 필요합니다. 기술의 흐름으로 보면 후보를 제안하는 망과 검출 망이 합성곱 특징을 공유하는 구조는 2015년에 발표된 Faster R-CNN에서도 쓰였고, 특허의 권리 범위는 요약이 아니라 청구항 문장으로 정해집니다.
용어 풀이
- [1] 검출 detection
화면에서 결함이 있는 자리를 찾아 상자나 영역으로 표시하는 일입니다. ↩ - [2] 분류 classification
찾아낸 결함이 어떤 종류인지 이름을 붙이는 일입니다. 수리할지 폐기할지가 이 이름으로 갈립니다. ↩ - [3] 신경망 neural network, CNN
여러 층의 계산을 거치며 이미지에서 특징을 뽑고 판정까지 하는 모델입니다. 이미지에는 합성곱 신경망(CNN)을 주로 씁니다. ↩ - [4] 백본 backbone
신경망 앞쪽에서 이미지의 특징을 뽑는 공통 부분입니다. 통합 구조에서는 검출과 분류가 이 부분을 함께 씁니다. ↩ - [5] ROI 풀링 region of interest pooling
특징 지도에서 후보 상자 안쪽만 떼어 일정한 크기로 모으는 계산입니다. 후보마다 백본을 다시 돌리지 않게 해 줍니다. ↩ - [6] WD working distance, 작동 거리
렌즈에서 검사할 면까지의 거리입니다. 본문 값은 얇은 렌즈 근사로 렌즈 중심을 기준으로 계산했습니다. ↩ - [7] 명시야 bright-field illumination
렌즈 축과 가까운 방향에서 빛을 비춰, 평평한 면이 밝게 보이고 빛을 흩는 흠이 어둡게 보이는 조명입니다. ↩ - [8] 암시야 dark-field illumination
낮은 각도에서 빛을 비춰, 평평한 면은 어둡고 흠이나 단차처럼 빛을 꺾는 자리만 밝게 보이는 조명입니다. ↩ - [9] 재현율 recall
실제 결함 가운데 검사기가 찾아낸 비율입니다. 95 %면 결함 100개 중 5개를 놓친다는 뜻입니다. ↩ - [10] 정밀도 precision
검사기가 어떤 이름을 붙인 결함 가운데 그 이름이 맞은 비율입니다. ↩ - [11] 회귀 테스트 세트 regression test set
모델을 고칠 때마다 똑같이 다시 돌려 보는 고정된 시험 이미지 묶음입니다. 성능이 나빠진 재학습을 잡아냅니다. ↩
참고 자료
- KLA Corp(원출원인 KLA-Tencor Corp), 미국 등록특허 US10607119B2 Unified neural network for defect detection and classification (우선일·출원일 2017년 9월 6일, 등록 2020년 3월 31일, 공개 US20190073568A1)
- S. Ren 외, Faster R-CNN: Towards Real-Time Object Detection with Region Proposal Networks (2015, 후보 영역 제안망과 검출 망이 합성곱 특징을 공유하는 구조)
- 계산식: 화소 분해능 = 최소 흠 폭 ÷ 3, 시야 = 화소 수 × 화소 분해능, WD ≈ f × (1 + 1/m), 프레임 수 = ⌈기판 폭 ÷ (시야 × 0.9)⌉ × ⌈기판 높이 ÷ (시야 × 0.9)⌉, 분리형 지연 = 백본 + 4 ms × 후보 수, 통합형 지연 = 백본 + 0.3 ms × 후보 수, 신뢰 구간 반폭 = 1.96 × √(p(1 − p) ÷ n)
함께 읽으면 좋은 글 — 과검출과 미검출, 어느 쪽이 더 비싼가 · 경량 모델은 왜 가장 가는 결함부터 놓칠까 · 딥러닝 vs 룰베이스(rule-based) 알고리즘, 언제 무엇을 쓰나

Noctvision
2005년부터 생산설비의 기계설계와 프로젝트 관리를 맡아 온 엔지니어입니다. 설비에 들어가는 카메라·렌즈·조명을 수식과 공개 자료로 계산하고, 가정과 출처를 함께 밝혀 기록합니다.


함께 읽으면 좋은 글
플랫필드 보정 게인은 조명 불균일과 함께 잡음도 키운다
딥러닝 vs 룰베이스(rule-based) 알고리즘, 언제 무엇을 쓰나