AOI의 불량 판정에 비전 언어 모델로 근거를 붙이려면
ALGORITHM
AOI가 남긴 ‘불량’ 한 단어에 이름과 근거를 붙이려면, 모델보다 먼저 조명 두 채널과 결함 10칸이 갖춰져 있어야 합니다.
PCB AOI 뒤에 비전 언어 모델을 붙이는 구성을 놓고, 모델이 근거로 삼을 수 있는 광학 증거와 사람 확인 큐의 크기를 계산했습니다.
읽는 시간 약 14분
AOI(automated optical inspection)1 화면에 PCB 한 장이 불량으로 떠 있습니다. 좌표 하나와 크롭 한 장, 이상 점수2 0.87이 전부입니다. 그런데 다음 공정이 알고 싶은 것은 점수보다 이름입니다. 솔더 브리지라면 리워크로, 부품 미삽이라면 실장 쪽으로, 먼지 한 올이라면 그냥 통과로 가야 하니까요.
이름이 없으면 비용은 두 군데서 생깁니다. 사람이 모든 판정을 다시 보니 자동 검사로 줄인 인건비가 돌아오고, 결함 유형별 발생 추이를 셀 수 없으니 공정을 고치는 피드백이 끊깁니다. 검사기는 돌아가는데 수율이 그대로인 라인이 이렇게 만들어집니다.
비전 언어 모델(vision language model, VLM)3은 이미지와 문장을 같은 표현 공간에서 다뤄, 크롭을 받아 결함의 이름과 그렇게 본 근거를 문장으로 내놓을 수 있습니다. 제가 따져 보려는 것은 모델의 성능표보다 앞단입니다. 모델이 근거로 말할 수 있는 것은 카메라와 조명이 미리 찍어 둔 차이뿐이고, 그 차이를 무엇으로 얼마나 만들어 두느냐가 이 구성의 성패를 가릅니다.
점수 0.87이 알려 주지 않는 것
이상 탐지기는 정상 이미지들이 모인 자리에서 얼마나 멀리 떨어졌는지를 재도록 만들어져 있습니다. 0.87은 그 거리를 0에서 1 사이로 눌러 담은 값이라, 출력에는 처음부터 결함 유형이라는 축이 없습니다. 모델을 아무리 키워도 거리 하나에서 이름이 나오지는 않아요.
유형 이름을 얻는 오래된 방법은 유형마다 라벨을 붙여 다중 클래스 분류기를 학습하는 것입니다. 이 길은 유형마다 수백 장의 라벨을 요구하고, 새 유형이 생길 때마다 다시 모아야 합니다. 비전 언어 모델은 유형 이름과 설명을 문장으로 받을 수 있어서 적은 라벨로 출발할 여지가 있지만, 얼마나 적은 라벨로 쓸 만한 정확도에 닿는지는 제품과 결함 분포에 따라 달라 샘플 테스트 전 확언 불가입니다.
어느 쪽이든 모델이 내놓는 근거 문장은 입력 이미지에 담긴 차이를 넘어설 수 없습니다. 브리지와 먼지가 같은 밝기로 찍힌 크롭이라면 모델은 둘을 가를 근거가 없고, 그럴듯한 문장으로 틀린 이름을 붙일 수도 있습니다. 근거는 빛이 만듭니다. 그래서 저는 이 구성에서 조명을 첫 줄에 둡니다.
브리지와 실밥은 조명 두 개로 갈린다
PCB 한 장에는 성질이 다른 면이 넷 섞여 있습니다. 녹색 솔더 마스크는 빛을 비교적 고르게 흩고, 동박 패드와 솔더는 금속이라 거울처럼 한 방향으로 튕겨 내며, 칩 부품의 몸체는 무광에 가깝습니다. 먼지나 섬유 조각은 빛을 사방으로 흩는 난반사4 면이고요. 같은 결함 후보라도 그 자리가 금속인지 난반사 면인지에 따라 조명에 대한 반응이 갈립니다.
동축낙사 조명5은 렌즈 축을 따라 위에서 빛을 내려보내, 수평에 가까운 금속 면만 카메라로 빛을 되돌립니다. 렌즈까지 166 mm, F/5.6이라면 렌즈 입구가 검사 면에서 보이는 반각은 1.5°이고, 점광원으로 치면 0.8° 남짓만 기울어도 금속 면은 어두워집니다. 저각 링 조명6은 반대로 낮은 각에서 비춰서, 링이 기판 위 15° 높이라면 37.5° 기운 금속 비탈이 카메라로 빛을 보냅니다. 솔더 필릿의 경사면이 링 아래에서 밝게 떠오르는 까닭입니다.
두 조명을 따로 켜고 찍으면 결함 후보마다 밝기가 두 개 생깁니다. 솔더 브리지는 금속이라 동축 아래에서는 꼭대기의 작은 평면만 반짝이고, 링 아래에서는 둥근 옆면이 밝은 테두리로 떠오릅니다. 섬유 조각은 난반사 면이라 두 조명 모두에서 고르게 흐릿하고, 링 아래에서는 빛이 비스듬히 닿는 만큼 어두워져 15° 입사라면 수직으로 받을 때의 26 % 정도입니다. 두 영상의 밝기 비가 재질을 말해 주는 셈이고, 모델이 ‘금속 광택이 옆면을 두르고 있다’는 근거를 쓰려면 이 두 장이 입력에 들어 있어야 합니다. 저는 이 비를 모델 입력에 함께 붙일 첫 속성으로 봅니다. 결함을 이런 물리 속성의 묶음으로 기술해 분류하는 생각은 특허에도 보이고, 아래 표의 두 건이 그 예입니다.
| 특허 번호 | 명칭 | 권리자 (원출원인) | 우선일 · 등록일 |
|---|---|---|---|
| US 12,361,531 B2 (공개 US 2022/0222806 A1) | Machine learning-based classification of defects in a semiconductor specimen | Applied Materials Israel Ltd. | 2019-05-22 · 2025-07-15 |
| US 10,599,951 B2 | Training a neural network for defect detection in low resolution images | KLA Corp (KLA-Tencor Corp) | 2018-03-28 · 2020-03-24 |
Applied Materials Israel의 특허는 결함마다 클래스를 가르는 데 도움이 되는 물리 속성 값을 여러 개 묶은 벡터로 내도록 기계 학습 모델을 학습시키고, 그 벡터를 클래스마다 정해 둔 속성 묶음과 맞춰 분류합니다. 두 조명의 밝기 비 같은 값이 그런 속성 후보가 될 수 있습니다. KLA의 특허는 고해상도 신경망이 합성한 결함 이미지를 섞어 저해상도 검사 영상용 신경망을 학습시켜, 고해상도 촬영보다 빠르게 결함을 찾는 방법입니다. 거칠게 찾고 촘촘하게 이름을 붙이는 이 분업이 다음 계산의 출발점입니다.
80 μm 브리지를 10칸에 담는 시야 32.8 mm
이름을 붙이려면 결함의 모양이 크롭 안에서 읽혀야 합니다. 제 기준은 80 μm 브리지가 10칸에 걸치는 8 μm/px이고, 4,096 × 3,000 px, 화소 3.45 μm인 12 MP급 컬러 센서로 계산하면(가정) 시야가 32.8 × 24.0 mm, 배율 0.431배입니다. 50 mm 렌즈라면 렌즈에서 기판까지 WD7가 약 166 mm라, 동축 조명과 저각 링을 함께 넣을 자리가 있는지가 첫 확인입니다.
컬러 센서의 베이어 배열8은 빨강과 파랑을 가로세로 두 칸에 하나씩만 받아서, 색으로 보면 간격이 16 μm로 넓어집니다. 80 μm 브리지에 색 표본이 5개 걸치는 정도라, 솔더의 은색과 동박의 구리색을 가르는 데는 충분하지만 브리지 가장자리의 모양은 밝기 채널에서 읽는 편이 안전합니다. 60 μm 이물은 7.5칸, 기준 위치에서 150 μm 틀어진 부품은 18.8칸 밀려 보입니다.
크롭 크기도 같은 계산에서 나옵니다. 256 × 256 px 크롭은 기판 위에서 2.05 mm 정사각형이라, 1.0 × 0.5 mm인 0402 칩이나 1.6 × 0.8 mm인 0603 칩은 주변 패드까지 한 장에 들어가고, 0.5 mm 간격 리드는 네 개가 담깁니다. 모델에게 결함만 잘라 주지 않고 이웃 리드까지 보여 줘야 ‘두 리드 사이를 잇는 금속’이라는 근거가 성립합니다.
기판 100 × 80 mm를 이 시야로 덮으면 이웃 프레임을 10 %씩 겹쳐 가로 4장, 세로 4장, 모두 16프레임입니다. 프레임마다 두 조명을 번갈아 찍어도 32장이고, 한 장에 40 ms가 걸린다고 치면 1.28초입니다. 모델이 후보 하나를 읽는 데 0.5초가 든다고 두면 후보 3건짜리 기판에서 1.5초가 더해집니다. 두 조명을 처음부터 모두 찍어 두면, 어떤 증거를 더 볼지 고르는 일은 다시 찍는 문제에서 모델에 무엇을 넣을지의 문제로 바뀝니다.
10칸
80 μm 브리지가 걸치는 화소 수 (8 μm/px)
2.05mm
256 px 크롭이 덮는 기판 위 정사각형
1.28초
16프레임 × 두 조명 촬영 시간 (한 장 40 ms 가정)
숫자를 나란히 놓으면 비싼 쪽이 어디인지 보입니다. 촬영은 기판 한 장에 1.28초면 끝나지만, 모델 추론과 사람 확인은 후보 수에 비례해 늘어납니다. 그래서 운용의 숫자는 후보가 얼마나 나오고 그중 몇 건을 사람이 보느냐에서 정해져요.
사람 확인 큐는 시간당 130건에서 시작한다
모델의 신뢰도가 낮은 건은 사람에게 보내는 것이 출발점입니다. 기판을 시간당 180장 검사하고, 장마다 후보가 3건 나오고, 처음에는 그 20 %가 신뢰도 0.6 아래라고 두면(가정) 사람이 볼 건은 시간당 108건입니다. 여기에 신뢰도가 높은 건 가운데 5 %를 무작위로 뽑아 확인하는 감사분 21.6건을 더하면 약 130건, 한 건에 10초면 시간마다 21.6분, 한 사람의 3분의 1 남짓이 이 큐에 묶입니다. 작지 않은 몫입니다.
무작위 감사를 굳이 넣는 까닭은 신뢰도가 낮은 건만 보면 ‘자신 있게 틀린’ 판정이 영영 드러나지 않기 때문입니다. 사람 확인 큐는 어려운 사례만 모으는 체라서, 그 결과로 잰 정확도는 모델 전체의 정확도와 다릅니다. 신뢰도 0.6이라는 숫자도 모델마다 뜻이 달라서, 감사 결과로 신뢰도 구간별 실제 정답률을 맞춰 보는 신뢰도 보정9을 함께 해야 합니다. 확인 결과는 버리지 않고 재학습으로 되돌리는데, 그림은 그 고리를 그린 개념도입니다.
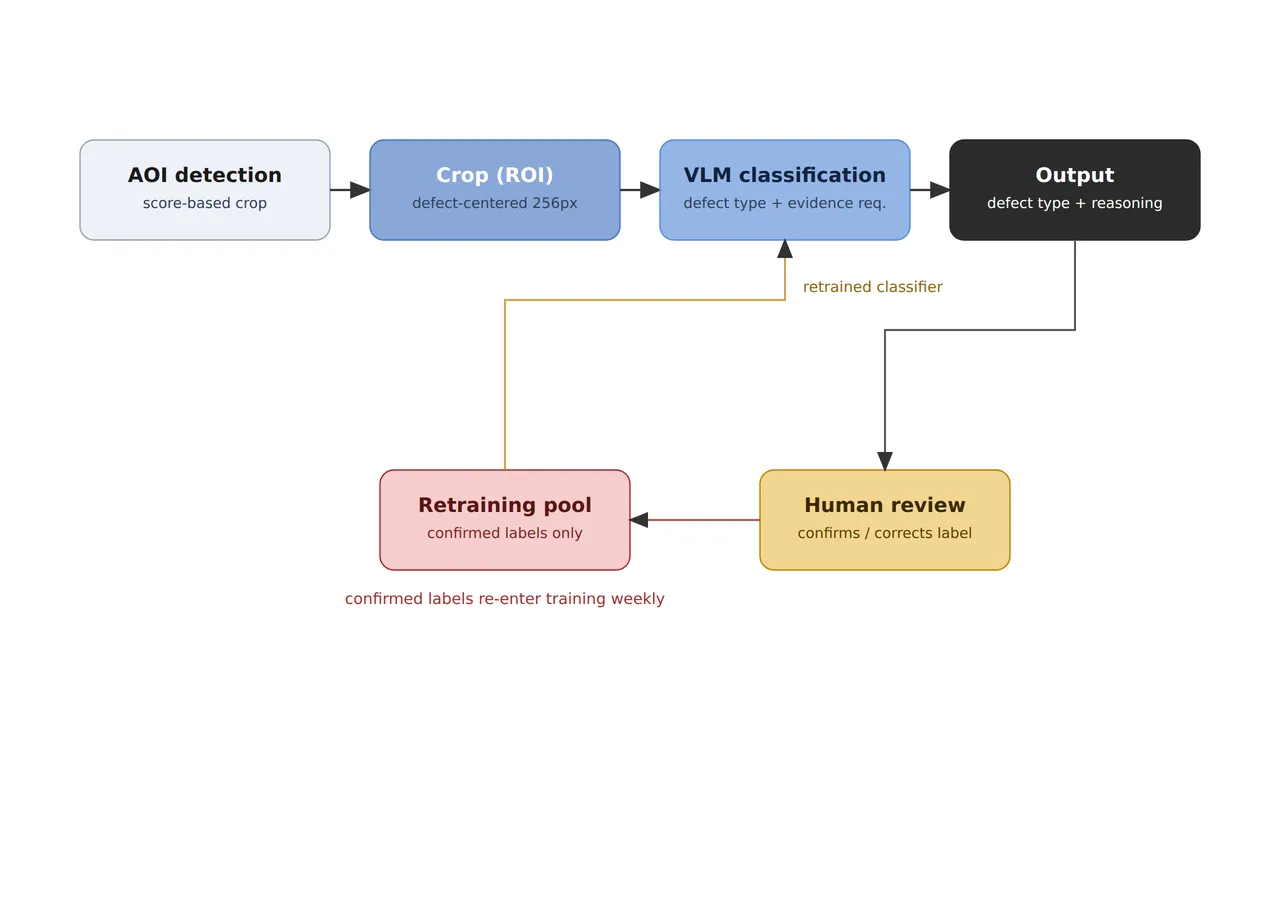
사람이 확인하거나 고친 라벨만 재학습 풀로 들어가고 매주 분류기로 되돌아가는 아래쪽 고리가, 이 구성의 정확도를 끌어올리는 길입니다. 고리를 도는 속도도 계산할 수 있습니다. 하루 16시간 가동이면 확인 라벨이 하루 2,070건 남짓 쌓이고, 발생 비율이 2 %인 드문 유형은 하루 41건이라 300건을 모으는 데 일주일 남짓 걸립니다. 정확도 90 %를 300건으로 재면 95 % 신뢰 구간10이 ±3.4 %p, 50건이면 ±8.3 %p라서, 드문 유형의 정확도는 첫 주에는 숫자로 말하기 어렵습니다.
그래서 사양서에는 목표 정확도 하나 대신 세 숫자를 적기를 권합니다. 첫 주의 정확도, 하루에 쌓이는 확인 라벨 수, 유형마다 300건이 모이는 날짜입니다. 이 세 숫자가 있어야 사람 확인을 언제 줄일 수 있는지에 답이 나옵니다.
판정 근거를 사양서에 옮기면
앞의 계산을 한 표에 모으면, 모델이 말할 근거와 그 근거를 만드는 하드웨어가 같은 줄에 놓입니다. 조명 두 채널과 증거 예산이 짝을 이룬다는 점이 표의 가운데 줄입니다.
| 항목 | 기준값 | 조건 · 근거 | 풀어 쓰면 |
|---|---|---|---|
| ① 최소 불량 크기 (μm) | 솔더 브리지 폭 80 μm, 표면 이물 직경 60 μm, 부품 틀어짐 150 μm | 8 μm/px에서 10칸 · 7.5칸 · 18.8칸. 색 표본은 16 μm 간격(베이어) | 모양은 밝기로, 색은 거칠게 읽는다 |
| ② 조명 | 동축낙사 + 저각 링(높이 15°) 2채널, 각각 독립 점등, 채널별 균일도 ±5 % 이내 | 링 15°는 37.5° 기운 금속 비탈을 밝힘. 두 채널의 밝기 비가 재질 속성 | 금속과 먼지는 두 조명에서 다르게 보인다 |
| ② 카메라 · 렌즈 · WD | 12 MP급 컬러 (4,096 × 3,000 px, 3.45 μm 가정), 50 mm F/5.6, 시야 32.8 × 24.0 mm | WD 약 166 mm 확보 필요(얇은 렌즈 근사), 두 조명 하우징과의 간섭 실측 | 조명 두 개가 렌즈 아래에 들어가야 한다 |
| ③ 알고리즘 파라미터 | AOI 검출 → 256 × 256 px 크롭(2.05 mm) + 두 조명 영상 + 정상 참조 1장 → VLM 유형 · 근거 | 신뢰도 0.6 미만 사람 확인(보정 뒤 재설정), 고신뢰 5 % 무작위 감사, 주 1회 재학습 | 자신 있게 틀린 경우는 감사로 찾는다 |
이 표에서 가장 먼저 무너지기 쉬운 칸은 ②의 조명 채널입니다. 조명이 동축 하나뿐이면 모델이 고를 수 있는 증거는 확대와 정상 참조뿐이라, 브리지와 금속성 이물처럼 모양이 비슷한 후보는 문장으로도 갈리지 않습니다. 저라면 알고리즘을 들이기로 한 시점에 광학 셋업을 다시 엽니다. 채널별 균일도 ±5 %도 같은 이유로 지킵니다. 두 채널의 밝기 비를 재질 속성으로 쓰는 한, 한 채널만 5 % 밝아져도 비율 전체가 5 % 밀리기 때문입니다.
이 구성이 맞지 않는 라인도 분명합니다. 결함 유형이 두세 가지로 고정되고 새 유형이 거의 생기지 않는다면, 유형별 라벨을 충분히 모아 다중 클래스 분류기로 가는 편이 추론 시간과 운용 모두에서 가볍습니다. 택트가 수십 ms 단위로 빠듯하다면 유형 분류를 검사 뒤 일괄 처리로 떼어 내는 편이 현실적이고, 판정 근거를 사람이 읽을 일이 없는 라인에서는 문장의 값이 낮아집니다. 광택이 강한 솔더와 반사 패드가 섞인 화면에서 모델의 근거 문장이 실제로 얼마나 맞는지는 샘플 테스트 전 확언 불가입니다.
모델을 고르는 일은 알고리즘 엔지니어의 몫이지만, 이 표의 조명 줄과 운용 줄은 설비와 품질 담당자가 함께 정해야 합니다. 사람 확인 큐에 한 사람의 3분의 1을 붙일 수 있는지, 드문 유형의 정확도를 일주일 뒤에 볼 수 있는지가 도입 일정을 정합니다. 도입 예산을 짜는 쪽에서는 ‘AI 분류’라는 이름보다 감사 비율과 라벨 회수 경로가 사양서에 적혀 있는지를 확인하면 됩니다. 이 글은 기술 설명이며 투자 권유가 아닙니다. 자세한 내용은 면책조항을 참고하세요.
현장 노트
AOI가 ‘불량’이라고만 남기는 라인에 비전 언어 모델을 붙인다면 저는 근거 문장보다 근거 영역을 앞에 둡니다. 모델이 짚은 영역이 실제 결함 위치와 맞는지를 확인 큐에서 50건쯤 표본으로 대조하고, 어긋난 건이 많다면 문장이 그럴듯해도 리워크 판단을 흐린다고 봅니다. 그다음 같은 후보를 동축 영상만 넣었을 때와 두 조명 영상을 넣었을 때로 나눠 이름이 바뀌는지 확인합니다. 바뀌지 않는다면 모델이 두 번째 조명을 근거로 쓰지 않는다는 뜻이라, 입력 구성을 다시 봅니다.
현장 체크포인트
근거 영역과 입력 구성을 확인했다면 아래 질문만 남습니다.
- 렌즈에서 기판까지 WD 약 166 mm(50 mm 렌즈, 시야 32.8 mm)가 동축 조명과 저각 링을 모두 단 상태에서 실제로 확보되는가? (도면 값 대신 설비 안에서 잰 거리인지)
- 모델이 고를 수 있는 조명 채널이 하드웨어에 실제로 두 개 이상 있는가? (동축 하나뿐이면 재질을 말할 근거가 없다)
- 80 μm 브리지가 10칸에 걸치고, 크롭 한 장이 이웃 리드까지 담는가? (256 px = 2.05 mm)
- 채널별 균일도가 ±5 % 안이고, 두 채널의 밝기 비를 정상품으로 기준 잡았는가?
- 신뢰도 0.6이 실제 정답률과 맞는지 감사 결과로 보정했는가? (모델마다 0.6의 뜻이 다르다)
- 고신뢰 판정의 5 % 무작위 감사와 사람 확인 큐의 인력(한 사람의 3분의 1 남짓)이 정해져 있는가?
- 확인 결과가 자동으로 재학습 풀에 쌓이고, 유형마다 300건이 모이는 날짜가 사양서에 적혀 있는가?
자주 묻는 질문
비전 언어 모델이 AOI 검출까지 대신할 수 있나요?
이 구성에서는 권하지 않습니다. 12 MP 프레임 하나를 256 px 조각으로 모두 덮으면 192장, 기판 한 장의 16프레임이면 3,072장이고, 한 장에 0.5초면 25.6분이 걸립니다. 후보 3건을 읽는 1.5초와 비교하면 천 배 넘게 깁니다. 검출은 빠른 이상 탐지기에 맡기고 모델은 후보에만 붙이는 분업이, 촬영 1.28초와 추론 1.5초라는 숫자를 지키는 길입니다.
정상 참조 1장은 왜 넣나요?
같은 부품 위치의 정상 크롭을 나란히 넣으면 모델이 원래 그 자리에 무엇이 있어야 하는지를 비교로 볼 수 있습니다. 부품이 빠졌거나 극성이 뒤집힌 결함은 결함 크롭 한 장만으로는 근거를 세우기 어렵습니다. 참조도 같은 두 조명 채널로 찍어 두어야 밝기 비 비교가 성립합니다.
용어 풀이
- [1] AOI automated optical inspection, 자동 광학 검사
카메라와 조명으로 기판이나 부품을 찍어 결함 후보를 자동으로 찾는 검사 장비입니다. 대개 결함 위치와 점수를 내놓습니다. ↩ - [2] 이상 점수 anomaly score
정상 이미지들의 분포에서 검사 이미지가 얼마나 떨어져 있는지를 나타낸 값입니다. 크면 이상하다는 뜻일 뿐, 무엇이 이상한지는 담지 않습니다. ↩ - [3] 비전 언어 모델 vision language model, VLM
이미지와 문장을 함께 입력받아 이미지에 대해 문장으로 답하는 모델입니다. 검사에서는 결함 이름과 그렇게 본 근거를 문장으로 낼 수 있습니다. ↩ - [4] 난반사 diffuse reflection
거친 면에서 빛이 사방으로 흩어지는 반사입니다. 조명 방향이 바뀌어도 밝기가 완만하게만 변합니다. ↩ - [5] 동축낙사 조명 coaxial illumination
반투명 거울로 빛을 꺾어 렌즈 축과 같은 방향에서 내려 비추는 조명입니다. 평평한 금속 면은 밝게, 기운 면은 어둡게 보입니다. ↩ - [6] 저각 링 조명 low-angle ring light
검사 면에 가까운 낮은 각도에서 고리 모양으로 둘러 비추는 조명입니다. 비탈과 모서리, 튀어나온 것이 밝게 떠오릅니다. ↩ - [7] WD working distance, 작동 거리
렌즈 앞에서 검사할 면까지의 거리입니다. 본문 값은 얇은 렌즈 근사로 렌즈 중심을 기준으로 계산했습니다. ↩ - [8] 베이어 배열 Bayer pattern
컬러 센서의 화소마다 빨강, 초록, 파랑 필터 가운데 하나를 바둑판처럼 얹은 배열입니다. 색 하나만 보면 화소 간격이 넓어집니다. ↩ - [9] 신뢰도 보정 confidence calibration
모델이 내놓은 신뢰도가 실제 정답률과 맞도록 맞춰 보는 작업입니다. 신뢰도 0.8로 낸 판정들이 실제로 80 % 맞는지를 확인합니다. ↩ - [10] 신뢰 구간 confidence interval
표본으로 잰 값이 참값을 어느 범위 안에 담는지를 나타내는 구간입니다. 표본이 적을수록 넓어집니다. ↩
참고 자료
- Applied Materials Israel Ltd., 미국 등록특허 US12361531B2 Machine learning-based classification of defects in a semiconductor specimen (공개 US20220222806A1, 우선일 2019년 5월 22일, 출원 2020년 3월 24일, 등록 2025년 7월 15일)
- KLA Corp(원출원인 KLA-Tencor Corp), 미국 등록특허 US10599951B2 Training a neural network for defect detection in low resolution images (우선일 2018년 3월 28일, 출원 2019년 3월 25일, 등록 2020년 3월 24일)
- 계산식: 시야 = 화소 수 × 화소 분해능, 배율 = 화소 크기 ÷ 화소 분해능, WD ≈ f × (1 + 1/m), 렌즈 입구 반각 = atan(조리개 지름 ÷ 2 ÷ WD), 링에 맞는 금속 비탈 = (90° − 링 높이각) ÷ 2, 난반사 면 조도 비 = sin(입사 높이각), 베이어 색 간격 = 2 × 화소 분해능, 프레임 수 = ⌈기판 폭 ÷ (시야 × 0.9)⌉ × ⌈기판 높이 ÷ (시야 × 0.9)⌉, 사람 확인 = 기판 수 × 후보 수 × (미달 비율 + (1 − 미달 비율) × 감사 비율), 신뢰 구간 반폭 = 1.96 × √(p(1 − p) ÷ n)
함께 읽으면 좋은 글 — 과검출과 미검출, 어느 쪽이 더 비싼가 · 딥러닝 vs 룰베이스(rule-based) 알고리즘, 언제 무엇을 쓰나 · 조명이 5 % 어두워지면 정상 화소 몇 개가 불량이 될까

Noctvision
2005년부터 생산설비의 기계설계와 프로젝트 관리를 맡아 온 엔지니어입니다. 설비에 들어가는 카메라·렌즈·조명을 수식과 공개 자료로 계산하고, 가정과 출처를 함께 밝혀 기록합니다.


함께 읽으면 좋은 글
카메라 인터페이스 대역폭이 분해능을 결정한다
높이가 흔들릴 때 텔레센트릭 렌즈는 F16보다 F7.1이 낫다